案例背景
美东时间11月12日13时25分,微软Microsoft 365的连接层出现故障,Outlook、Teams、Copilot与OneDrive相继不可用,波及至少74个国家和地区。网络监测平台Downdetector在全球记录到超过740万条报障,峰值接近每分钟两万条,是正常水平的1500倍以上;其中Outlook的报障峰值在美东13时达到138058条,到傍晚回落至34490条,Microsoft 365相关报障一度接近1.3万条。
微软随后致歉,并明确排除了网络攻击与AI、Agent因素,称故障源于早先一次网络容量升级引入的缺陷,在近期的网络变更后被触发。处置措施包括暂停全部部署变更、迁移流量与重启服务器,但恢复过程反复——重新投用的服务器在接入流量后可能再次无响应,整个过程前后持续近18小时。日本政府共通数字底座GSS被迫改用电话,澳大利亚情报机构与联邦警察、英国NHS与伦敦警察厅、欧洲交易所运营商Euronext、英国保险商Aviva与航运巨头马士基均受波及;印度IndiGo、Akasa Air与印度航空的邮件客服中断;台湾地区券商、寿险与投信机构受影响,一家公司取消了债券回购交易,另一家只能用传真确认交易。有机构估算全球保险损失在3亿至5亿美元之间,远低于2024年CrowdStrike事件约850万台Windows设备蓝屏所对应的4亿至15亿美元。微软股价周五收平于523.88美元,年内上涨约8%。
核心分析
一、一次容量变更如何演化为全球性级联失效
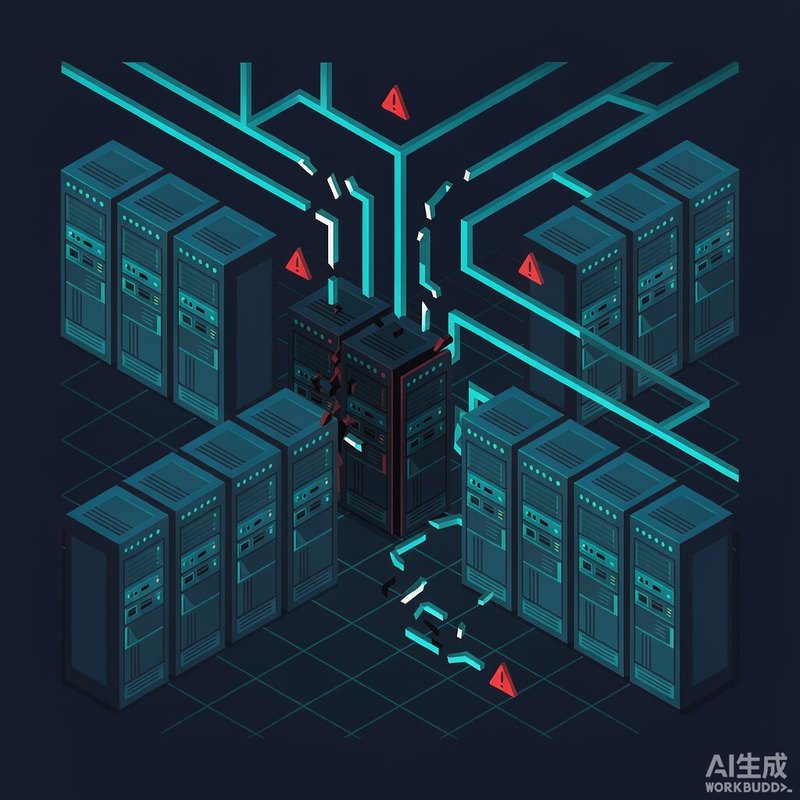
从公开信息看,这不是某个组件「坏掉」,而是一条典型的级联失效链条:容量升级未按预期生效,健康校验机制据此判定部分机器「出局」,流量被压向剩余节点,剩余节点超载后又触发更多健康检查失败,形成自我强化的负反馈。更棘手的是恢复阶段的反复——服务器重新接入流量后再次无响应,说明系统在「半恢复」状态下缺乏足够的缓冲与限流设计。传统高可用架构默认故障是局部的、可隔离的,但当控制平面本身(连接层、身份认证、流量调度)成为单点,冗余节点反而可能被同一缺陷同时击穿。值得注意的是,这与2024年CrowdStrike事件在机理上并不相同:后者是内容更新推送到终端导致的批量蓝屏,属于「推错了东西」,可以靠回滚迅速止损;此次则是容量变更改变了系统的受力结构,属于「东西没错但秩序乱了」,必须等流量重新分布、状态重新收敛,这也解释了为何恢复时间更长、反复更多。级联失效的可怕之处正在于此:它不制造新的错误,只是把系统原有的余量一点点耗尽。对管理者而言,现代信息系统的脆弱性往往不在硬件冗余度,而在变更管理与控制面的耦合度。
二、韧性不是免费的:效率最优与失效可控的取舍
过去十年,云与SaaS的主流叙事是「规模效应带来更低成本、更高可靠性」,企业乐于把邮件、协作、身份与AI助手统一到一个供应商,以降低集成复杂度。但这次事件暴露了一个被低估的权衡:极致的集中化提升了常态效率,却压缩了失效时的「退化空间」。真正有韧性的组织,不是不出故障,而是故障发生时仍能维持关键业务的最低运转——日本政府退回电话、Aviva启用财报电话会备份、台湾机构用传真确认交易,这些看似「原始」的手段恰恰是韧性的一部分。韧性的本质是保留冗余与可切换路径,而冗余在平时看起来就是浪费。这正是韧性投入总是滞后于事故的原因:收益只在极小概率的时刻兑现,成本却要在每一张资产负债表上长期计提。服务等级协议在这一层几乎失效:它承诺的是可用性百分比与费用返还,却无法补偿业务停摆、客户流失与声誉折损。管理者真正该问的不是「供应商能赔我多少」,而是「我自己有没有第二条路」。冗余在财务上表现为成本,在战略上表现为选择权,两者的计价方式从来不同。
三、骂而不走:转换成本与AI时代的新型耦合
事故之后客户的普遍反应是抱怨而非迁移,这并非不理性。单一供应商的转换成本不仅包括显性的迁移费用,更包括组织习惯、权限体系、数据资产与生态集成的深度绑定,切换的摩擦远高于事故带来的边际痛苦。更值得关注的是AI带来的新耦合:Copilot等Agent能力依赖底层的连接组件与身份服务,OpenAI与Anthropic使用的微软连接组件同样被拖慢,这意味着AI不是叠加在旧架构上的「智能层」,而是把更多业务逻辑挂到了同一根管子上。当Agent开始代替人执行跨系统任务,单点故障的传导速度与影响半径都会被放大。还要看到,AI供应商之间的互相依赖正在加深:模型公司跑在云上,云跑在连接层上,连接层又跑在少数几家网络设备与身份服务之上,链条越长,单点的杠杆越大。因此采购决策不能只看单点性能,还要数一数这条链上有多少环节属于「别无分店」。对平台战略而言,谁能把「可控的降级」做成产品能力——多活、可切换、故障时优雅退化——谁才真正握有企业级市场的定价权。
管理启示
这起事故的价值不在于「微软也会宕机」,而在于它把三个常被忽视的管理命题摆上台面。第一,变更管理是第一风险源,绝大多数重大事故源于「正常操作」而非外部攻击,变更的灰度、回滚与可观测性应被视为核心资产。第二,韧性需要被显性化为指标与预算,而不是停留在口号,例如关键业务的降级预案、跨供应商的可切换能力、故障演练的频率。第三,供应商风险评估要从「服务等级协议」转向「依赖图谱」,厘清自己在多大程度上把命运交给了同一条连接层。对正在部署AI Agent的企业而言,尤其要先问一句:当这根管子断了,哪些流程还能跑?
其他思考
- 「高可用」与「高韧性」不是同义词:前者追求不出事,后者追求出了事还能活。企业采购云服务时,是否把「故障时的降级能力」写进评估清单,而不只是看正常运行时间?
- AI Agent的普及正把「软件依赖」变成「流程依赖」。当智能体承担越来越多的跨系统操作,单点故障会从「一个工具用不了」升级为「一条业务链停摆」,风险治理的颗粒度需要同步细化。
- 保险与合同是风险转移的最后一环,却常在前期谈判中被忽视。3亿至5亿美元的估算损失与CrowdStrike事件的差距,恰恰说明「损失可计量」本身就是一种议价能力。
关键词:级联失效、系统韧性、单点依赖、变更管理
来源:Downdetector、Microsoft 365状态页、路透社 | 整理:经管大课堂
原文链接:https://www.rcbom.com/aibps/7308.html